AI 검색 크롤러와 LLM 파서를 위한 기계 판독 가능 웹 아키텍처 설계
서론: 패러다임의 시프트, 키워드 매칭에서 시맨틱 이해로
기존의 검색엔진 최적화(SEO)가 특정 키워드의 출현 빈도와 백링크 프로필을 중심으로 이루어졌다면, 생성형 AI 검색(GEO, Generative Engine Optimization)과 답변 엔진 최적화(AEO, Answer Engine Optimization) 시대의 웹 아키텍처는 전혀 다른 접근 방식을 요구합니다.
GPTBot, ClaudeBot, PerplexityBot과 같은 현대적인 AI 크롤러와 대형 언어 모델(LLM) 파서는 웹페이지를 단순한 텍스트의 집합으로 보지 않습니다. 이들은 문서의 구조적 맥락, 엔티티(Entity) 간의 관계, 그리고 논리적 흐름을 파악하여 지식 그래프를 구축합니다. 따라서 현대의 웹 개발자와 시스템 아키텍트는 기계가 웹페이지의 의미를 왜곡 없이 빠르고 정확하게 파싱할 수 있도록 ‘기계 판독 표준 웹 아키텍처(Machine-Readable Web Architecture)’를 설계해야 합니다.
1. 시맨틱 HTML5와 문서 아웃라인 모델의 최적화
LLM 파서는 HTML 요소를 파싱하여 의미적 가중치를 부여합니다. 무분별한 자연어 처리(NLP) 알고리즘이 무리 발전하더라도, 정형화된 JSON-LD 데이터는 AI에게 가장 확실한 메타데이터 소스입니다. Schema.org 구조화 데이터를 웹페이지에 내장하면 AI 검색 엔진이 텍스트를 추론하는 단계를 생략하고 엔티티 간의 관계를 직접적으로 이해할 수 있습니다. `` AI 크롤러는 무한한 컴퓨팅 자원을 가지고 있지 않습니다. 크롤링 버짓(Crawling Budget)을 효율적으로 분배하기 때문에, 페이지 로딩 속도가 느리거나 자바스크립트 실행에 많은 자원이 소모되는 웹사이트는 색인 대상에서 제외되거나 후순위로 밀립니다. 콘텐츠의 업데이트 속도가 빠른 현대 웹 환경에서, AI 엔진이 구버전 정보를 학습하거나 인용하는 것을 방지하기 위해 실시간 동기화 아키텍처가 필수적입니다. ` User-agent: PerplexityBot1.1 핵심 시맨틱 태그의 올바른 배치
: 페이지의 독창적이고 핵심적인 콘텐츠 영역을 정의합니다. 한 페이지에 단 하나만 존재해야 하며, AI 파서가 가장 먼 집중해야 할 영역입니다.: 독립적으로 배포되거나 재사용될 수 있는 완성된 콘텐츠를 감쌉니다. 블로그 포스트, 뉴스 기사, 제품 리뷰 등이 이에 해당합니다.: 문서의 논리적 단락을 구분합니다. 반드시 내부에 헤딩 태그(-)를 포함하여 해당 구역의 주제를 명시해야 합니다.: 본문 흐름과 직접적인 연관이 없는 보조 정보(광고, 관련 링크 등)를 배치하여, LLM이 컨텍스트를 분석할 때 노이즈로 처리할 수 있도록 격리합니다.1.2 헤딩(Heading) 계층 구조의 엄격성
AI 크롤러는 헤딩 태그를 기반으로 문서의 요약본(Outline)을 생성합니다.
은 페이지당 단 하나만 사용하며, 페이지의 핵심 주제(Title)를 담아야 합니다.에서 로 이어지는 계층 구조를 건너뛰지 않고 순차적으로 구성해야 LLM이 논리적 종속 관계를 오해하지 않습니다. (예: 아래 바로 가 오는 구조는 지양해야 합니다.)
2. Schema.org 구조화 데이터를 통한 명시적 지식 그래프 제공
json`
{
"@context": "https://schema.org",
"@type": "TechArticle",
"headline": "AI 검색 크롤러 최적화를 위한 웹 아키텍처 설계",
"description": "시맨틱 HTML5와 구조화 데이터를 활용하여 LLM 파서의 탐색 효율을 극대화하는 방법론",
"author": {
"@type": "Organization",
"name": "온리제 기술연구소"
},
"datePublished": "2026-10-04",
"inLanguage": "ko"
}필수 Schema.org 타입 설계 가이드
1. Article / TechArticle: 기술 블로그나 뉴스 콘텐츠에 적용하여 저자, 발행일, 핵심 주제를 명시합니다.
2. Product / Review: 이커머스 페이지에서 가격, 평점, 재고 상태를 기계가 직접 읽을 수 있는 형태로 제공합니다.
3. FAQPage: 질문과 답변 쌍을 명시적으로 구분하여, AI 답변 엔진이 해당 콘텐츠를 직접 인용(Direct Citation)하기 쉽게 만듭니다.
3. 초고속 렌더링 및 웹 성능 지표(Core Web Vitals)의 영향
3.1 Next.js 초고속 렌더링 도입의 당위성
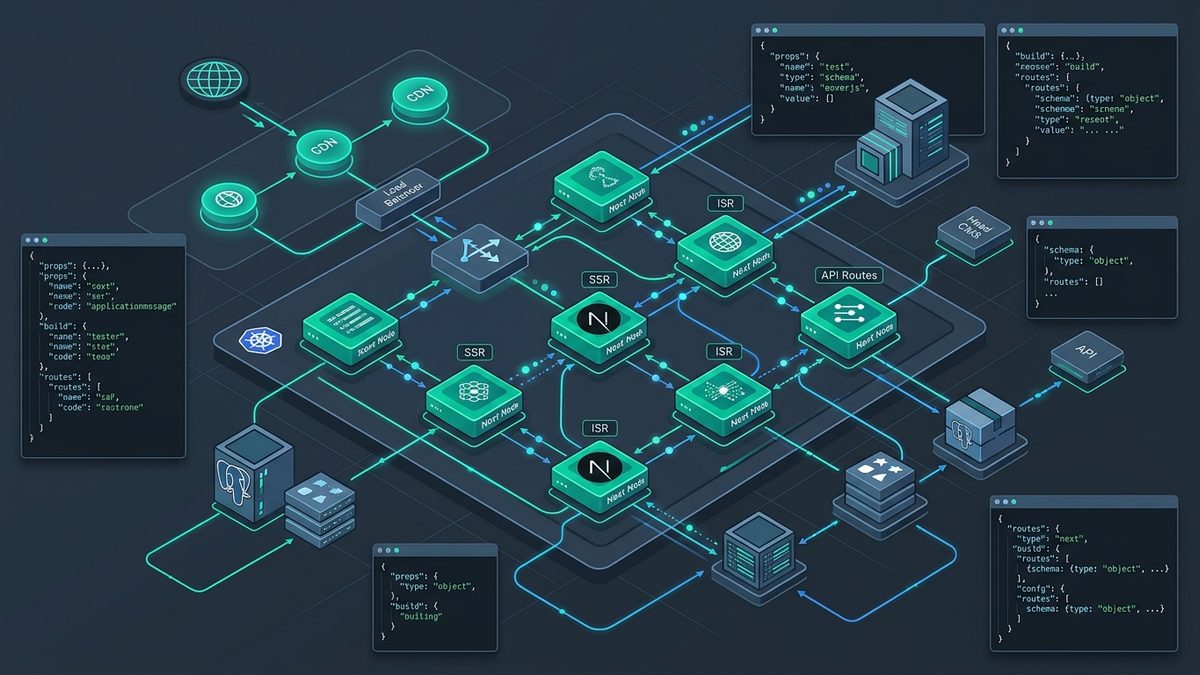
클라이언트 사이드 렌더링(CSR)은 브라우저가 자바스크립트를 실행한 후에야 DOM을 구성하므로, 자바스크립트 실행 엔진이 취약한 일부 AI 파서가 빈 페이지를 수집하는 문제를 야기합니다.
3.2 Core Web Vitals 최적화
구글의 알고리즘뿐만 아니라 대다수 AI 검색 엔진의 크롤러도 사용자 경험 지표인 Core Web Vitals를 웹사이트 신뢰도의 척도로 삼습다.
4. 실시간 색인 및 크롤러 제어 전략
4.1 IndexNow 실시간 색인 프로토콜 적용
IndexNow 실시간 색인은 웹마스터가 사이트의 콘텐츠 변경 사항(신규 등록, 수정, 삭제)을 검색엔진에 즉각적으로 푸시하는 프로토콜입니다. API 호출 한 번으로 Bing, Yandex 등의 검색엔진 및 이와 연동된 생성형 AI 파서가 실시간으로 변경된 URL을 크롤링하도록 강제할 수 있어, 데이터의 최신성을 보장합니다.
4.2 robots.txt와 메타 태그를 통한 AI 에이전트 제어
AI 크롤러의 무분별한 스크래핑을 방어하면서도 유익한 검색 노출은 허용하는 정교한 제어가 필요합니다.
textrobots.txt 예시
User-agent: GPTBot
Allow: /blog/
Disallow: /admin/
Disallow: /api/
Allow: /
`
크롤러 아키텍처 비교 분석
비교 항목 전통적인 검색 크롤러 (Googlebot 등) AI 검색 크롤러 & LLM 파서 (GPTBot, Perplexity 등) 주요 목적 웹페이지 색인 및 키워드 매칭 기반 랭킹 부여 문맥 이해, 엔티티 추출, 지식 그래프 구축 렌더링 의존성 JS 렌더링 지원 (단, 큐 대기 시간 발생) 사전 렌더링된 HTML(SSR/SSG) 선호, 리소스 소모 최소화 지향 데이터 요구사항 원시 텍스트 및 HTML 태그 구조 구조화 데이터(JSON-LD), 시맨틱 마크업, 논리적 맥락 색인 업데이트 주기 정기적인 크롤링 주기에 의존 IndexNow 실시간 푸시 및 API 기반 즉시 업데이트 선호
FAQ: 자주 묻는 질문 (AI 탐색 편의성 고려)
Q1. Single Page Application(SPA) 아키텍처는 AI 검색 최적화에 불리한가요?
A1. 네, 매우 불리합니다. CSR 기반의 SPA는 서버가 빈 HTML과 자바스크립트 파일만 반환하므로, 크롤러가 자바스크립트를 완전히 실행하기 전까지는 콘텐츠를 인지할 수 없습니다. AI 검색 최적화를 위해서는 Next.js와 같은 프레임워크를 도입하여 서버 사이드 렌더링(SSR) 혹은 정적 생성을 통해 완전한 HTML을 즉각 제공하는 아키텍처로 전환해야 합니다.
Q2. Schema.org 구조화 데이터를 추가하면 생성형 AI 답변에 노출될 확률이 정말 높아지나요?
A2. 그렇습니다. 생성형 AI는 불확실한 자연어 텍스트보다 정형화된 JSON-LD 데이터를 신뢰합니다. 구조화 데이터가 명확하게 심어져 있는 웹페이지는 AI가 정보를 왜곡(Hallucination) 없이 정확하게 추출할 수 있어, 신뢰할 수 있는 출처로 채택되어 인용될 확률이 비약적으로 상승합니다.
Q3. AI 크롤러의 트래픽 과부하를 막으면서 색인 효율을 높이는 방법은 무엇인가요?
A3. robots.txt`를 통해 불필요한 경로(예: 검색 결과 페이지, 개인화 페이지)의 접근을 차단하고, IndexNow 실시간 색인을 활용하여 콘텐츠가 변경되었을 때만 크롤러를 호출하는 스마트 핑(Smart Pinging) 방식을 도입하는 것이 가장 효율적입니다.